2011年11月6日日曜日

Excel列名変換

また、こちらのブログを見てチャレンジ。

http://d.hatena.ne.jp/JunichiIto/20111102/1320253815


Scalaで書いてみたけど、Scalaっぽいのかわからない。

object Main {

  val cols = Range('A'.toInt, 'Z'.toInt + 1, 1).map {
    n => n.toChar
  }

  val stringPattern = "[A-Z]+".r

  def toNumber(alpha: String, num: Int): Int = {
    if (alpha.isEmpty) {
      num
    } else {
      toNumber(alpha.drop(1), num * 26 + (cols.indexOf(alpha.head) + 1))
    }
  }

  def toAlpha(num: Int, alpha: String): String = {
    if (num <= 0) {
      alpha
    } else {
      (num % 26) match {
        case 0 => cols(25) + alpha
        case n: Int => toAlpha(num / 26, cols(n - 1) + alpha)
      }
    }
  }

  def main(args: Array[String]) {
    args(0) match {
      case stringPattern() =>
        println(toNumber(args(0), 0))
      case _ =>
        println(toAlpha(args(0).toInt, ""))
    }
  }
}

2011年11月5日土曜日

Oracle NoSQLをCentOSインストール


NoSQL Databaseのダウンロード

Oracleのサイト(下記リンク)から、NoSQL Databaseのアーカイブをダウンロードする。
http://www.oracle.com/technetwork/database/nosqldb/downloads/index.html

ダウンロードしたファイルは、任意のディレクトリに解凍してあげる。

インストールされたことを確認

以下のように、kvclient-1.1.100.jarを実行して標準出力に「11gR2.1.1.100」が出力されればOK
$ KVHOME=/opt/kv-1.1.100 
$ export KVHOME 
$ java -jar $KVHOME/lib/kvclient-1.1.100.jar 
11gR2.1.1.100

データベースの作成

testディレクトリを作成し、そこをルートとしてデータベースを作成。
-portには、データベースにアクセスするためのポートを指定。(Oracle Databaseの1521みたいなものかな?)
-adminには、管理者用のポートを設定。このポートにアクセスすれば、GUIベースの管理ができる。
-hrangeには、ノード自身が通信で使うポートの開始位置と終了位置を指定するらしい。(あんまりよく分かっていない。。)
$ mkdir test
$ $KVHOME/bin/kvctl makebootconfig -root test -port 5000 -admin 5001 -harange 5010,5020

データベースの起動

下記コマンドで起動する。
-rootには、データベースのルートディレクトリを設定する。
$ $KVHOME/bin/kvctl start -root test

起動されたことは、tnsping的な下記コマンドで確認する。
$ $KVHOME/bin/kvctl ping -port 5000

成功していると、こんなメッセージが出力されるみたい。
SNA at hostname: localhost.localdomain, registry port: 5000 is not registered.
        No further information is available

ためしに管理者用ポートにブラウザからアクセスしたらこんな画面が表示されました。

データベースの停止

$KVHOME/bin/kvctl stop -root test

2011年10月30日日曜日

[mysql]indexが使われていないSQLを調べる方法

log_queries_not_using_indexesというオプションを有効にすることによって、indexが使われていないSQLを抽出することができる。

log_queries_not_using_indexesオプションの値の確認・設定方法


global variablesの値が「on」になっていれば、indexが使われていないSQLが抽出できます。
mysql> show  global variables like '%indexes';
+-------------------------------+-------+
| Variable_name                 | Value |
+-------------------------------+-------+
| log_queries_not_using_indexes | ON    |
+-------------------------------+-------+
1 row in set (0.00 sec)

もし、offになっている場合には以下のコマンドで有効に変更できます。
mysql> set global log_queries_not_using_indexes = on;

抽出されたSQLの出力先

log_queries_not_using_indexesのログは、slow queryログに出力されるのでslow queryの設定で確認できます。

slow_query_logが、slow queryログを出力するかどうかの設定。onになっていれば、ログが出力されます。
slow_query_log_fileが、ログの出力先となります。
mysql> show global variables like '%slow%';
+---------------------+------------------+
| Variable_name       | Value            |
+---------------------+------------------+
| log_slow_queries    | ON               |
| slow_launch_time    | 2                |
| slow_query_log      | ON               | 
| slow_query_log_file | c:\work\slow.log |
+---------------------+------------------+
4 rows in set (0.00 sec)

slow queryの設定は、以下のように「set global」コマンドで変更できます。
mysql> set global slow_query_log = on;
Query OK, 0 rows affected (0.00 sec)

mysql> set global slow_query_log_file = 'c:\\slow.log';
Query OK, 0 rows affected (0.00 sec)

動作を確認してみよう


テスト用に主キーのみのテーブルを作成
mysql> create table test_table (col1 char(1), primary key (col1));
Query OK, 0 rows affected (0.02 sec)

以下の2種類のSQLを実行。前者のSQLは、主キー検索のためindexが使用される。
後者のSQLは、関数を使用しているのでindexは使用されずに検索が行われる。
mysql> select * from test_table where col1 = '1';
Empty set (0.00 sec)

mysql> select * from test_table where substr(col1, 1, 1) = '1';
Empty set (0.00 sec)

slow queryログには、以下のようにindexが使用されなかったSQLの情報が取得できる。
# Time: 111030 16:00:38
# User@Host: root[root] @ localhost [::1]
# Query_time: 0.000500  Lock_time: 0.000000 Rows_sent: 0  Rows_examined: 0
use test_db;
SET timestamp=1319958038;
select * from test_table where substr(col1, 1, 1) = '1';

これを使えばindexの張り忘れや、SQLのつくりが原因でindex使われていないSQLを機械的に抽出できるかなと。

2011年10月25日火曜日

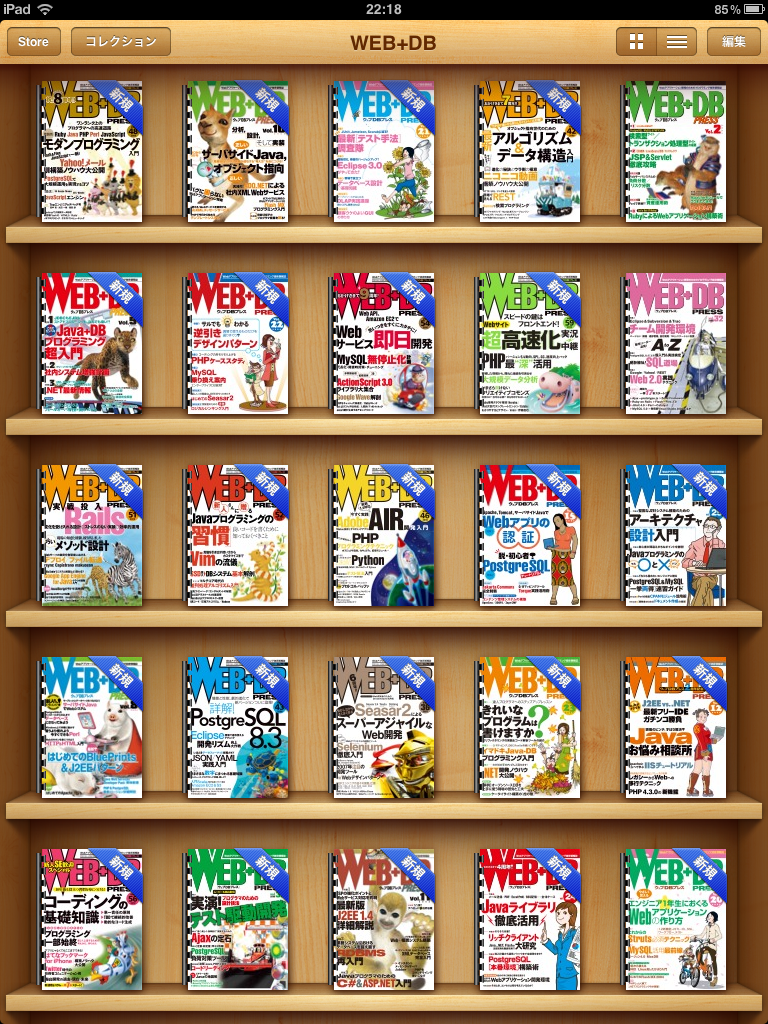
WEB+DB PRESS 総集編

WEB+DB PRESS 総集編が届いたので、がっつりiPadに取り込んでみた。


iBooksで見るとかんな感じ。

iPadだとやや重いかなって感じです。普通に読むぶんにはまぁそこまで気にならないかなと。


2011年10月11日火曜日

FizzBuzz

http://d.hatena.ne.jp/JunichiIto/20111007/1317976730を見て俺もかけなかったらどうしようと不安になりつつScalaで書いてみた。
とりあえず、ちゃんと動くものかけて一安心と。

(1 to args(0).toInt).foreach {
  n =>
    (n % 3, n % 5) match {
      case (0, 0) => println("Fizz Buzz")
      case (0, _) => println("Fizz")
      case (_, 0) => println("Buzz")
      case _ => println(n)
    }
}

Excelの関数でもしてみた。。。現在の行番号を元に結果が出てくるようにしてます。
=IF(MOD(ROW(),15)=0,"Fizz Buzz",IF(MOD(ROW(),3)=0,"Fizz",IF(MOD(ROW(),5)=0,"Buzz",ROW())))

2011年9月29日木曜日

Vimテクニカルバイブルを買ったよ。

Vimユーザなので購入。


emacs版もあるらしい。emacs使えないから買うことはないけど。

2011年9月25日日曜日

[Scala]アクセッサの定義

scalaではとあるルールによってアクスメソッド(getterやsetter)が自動的に定義されるので、
Javaみたく明示的にアクセスメソッドを定義する必要はないようです。素敵ですね。


パターン1:publicなvarフィールドを定義した場合

このように、publicなvarフィールドを定義するとコンパイル時に自動的にアクセスメソッドを出力してくれます。
class Hoge {

  var hoge1: String = _

  var hoge2: Int = _
}
自動で生成されたアクセスメソッドを呼び出すには、フィールドに直接アクセスするようにしてあげればよいです。
val hoge = new Hoge
hoge.hoge1 = "hoge"     // hoge1に値を設定
hoge.hoge2 = 1             // hoge2に値を設定

println(hoge.hoge1)        // hoge1の値を取得
println(hoge.hoge2)        // hoge2の値を取得

コンパイル後に出力されたクラスファイルをjadって見てみると、こんなルールになっているのがわかる。
  • varなフィールドはprivateになっている。
  • setterは、プロパティ名 + "_="になっている。
    =は、コンパイル時にJavaで認識できる文字に置き換えられるので「$eq」となっている。
  • getterは、プロパティ名になっている。
//***********************************************
// Hogeクラス
//***********************************************
public class Hoge 
    implements ScalaObject 
{ 
    // hoge1のgetter
    public String hoge1() 
    { 
        return hoge1; 
    } 
    // hoge1のsetter
    public void hoge1_$eq(String s) 
    { 
        hoge1 = s; 
    } 
    // hoge2のgetter
    public int hoge2() 
    { 
        return hoge2; 
    } 
    // hoge2のsetter
    public void hoge2_$eq(int i) 
    { 
        hoge2 = i; 
    } 
 
    public Hoge() 
    { 
    } 
 
    // 公開フィールドは、privateなフィールドとなっている。
    private String hoge1; 
    private int hoge2; 
} 

//***********************************************
// アクセスメソッドを呼び出すコード
//***********************************************
Hoge hoge = new Hoge();
// setter(プロパティ名 + "_=")を呼び出すコードに変換されているのがわかる。
hoge.hoge1_$eq("hoge");
hoge.hoge2_$eq(1);

Predef$.MODULE$.println(hoge.hoge1());
Predef$.MODULE$.println(BoxesRunTime.boxToInteger(hoge.hoge2()));
ちなみち、varフィールドをprivateにするとアクセスメソッドが生成されないのでこんな感じにコンパイルエラーが出る。
    Error:Error:line (6)error: variable hoge1 in class Hoge cannot be accessed in Hoge
hoge.hoge1 = "hoge"
    Error:Error:line (7)error: variable hoge2 in class Hoge cannot be accessed in Hoge
hoge.hoge2 = 1
    Error:Error:line (9)error: variable hoge1 in class Hoge cannot be accessed in Hoge
println(hoge.hoge1)
    Error:Error:line (10)error: variable hoge2 in class Hoge cannot be accessed in Hoge
println(hoge.hoge2)

パターン2:明示的にアクセスメソッドを定義する方法

明示的にアクセスメソッドを定義するには、フィールドをprivateにしてあげてパターン1で自動生成された形式でsetterとgetterを宣言してあげればよいです。
例えば、アクセスメソッドで処理をしたい場合やgetterのみを宣言する場合に使います。(Javaのように、getHogeやsetHogeを宣言する必要はないです。)
気をつけないといけないのは、フィールド名とgetter名が同じになってはいけないのと、
setter名は、プロパティ名の後に「_=」をつけるのを忘れないこと。「_」と「=」の間にスペース入れちゃうのもダメ。
  // フィールドはprivateで宣言する。
  private var h1: String = _
  private var h2: Int = _

  // getter
  def hoge1: String = h1

  // setter
  def hoge2_=(hoge2: Int) {
    require(hoge2 > 100)
    h2 = hoge2;
  }
  // getter
  def hoge2: Int = h2